


モルフォが公開した新ソリューション『Morpho VLM Fluid Action』の全貌と活用事例
モルフォが公開した新ソリューション『Morpho VLM Fluid Action』の全貌
株式会社モルフォが新たに発表したソリューション『Morpho VLM Fluid Action』は、カメラ映像の解析に基づく視覚と言語の統合モデルで、新時代の映像分析技術を切り拓くものです。本記事では、このソリューションの特徴や実用化の可能性について詳しく解説いたします。
新しい映像分析のアプローチ
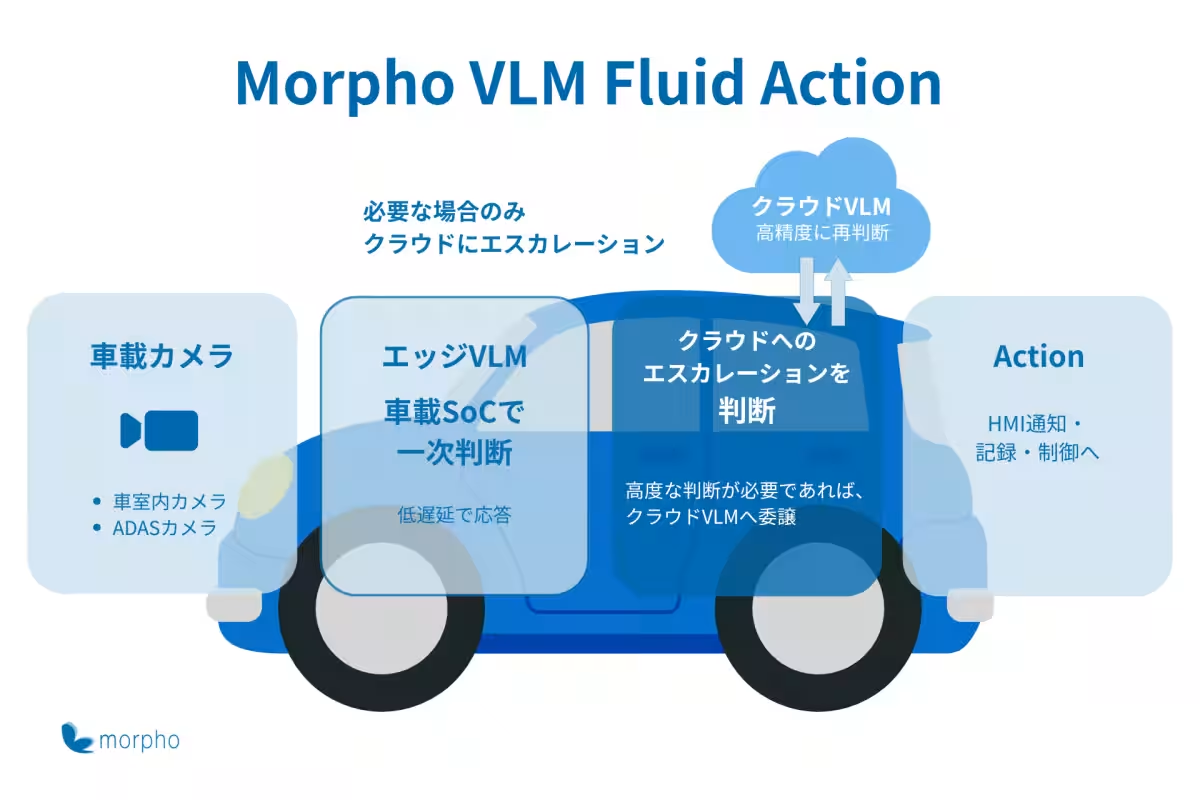
『Morpho VLM Fluid Action』は、Vision-Language Model(VLM)を使用して映像から取得した情報を即座に処理し、適切なアクションにつなげることができる革新的な技術です。この仕組みの本質は、映像の内容を理解するだけでなく、その結果に基づいた行動を設定することにあります。例えば、車内に荷物が残されている際には、その状況を適切に認識し、乗員の乗降状況を考慮して通知する機能を担います。
従来の技術では、特異なシーンや収集困難な学習データが問題でしたが、VLMを活用することで、大量の事前データなしに状況を認識することが可能になります。
VLMの特徴と利点
VLMは、地図のように視覚と言語を統合して扱うAIモデルです。通常の大規模言語モデル(LLM)がテキストを扱うのに対し、VLMは画像や映像とともに言葉を理解する力を持っています。これにより、モルフォは認識技術を円滑に進化させ、ユーザーのニーズに応じたアクションをデザインすることに成功しています。
柔軟な設定とエッジ端末での判断
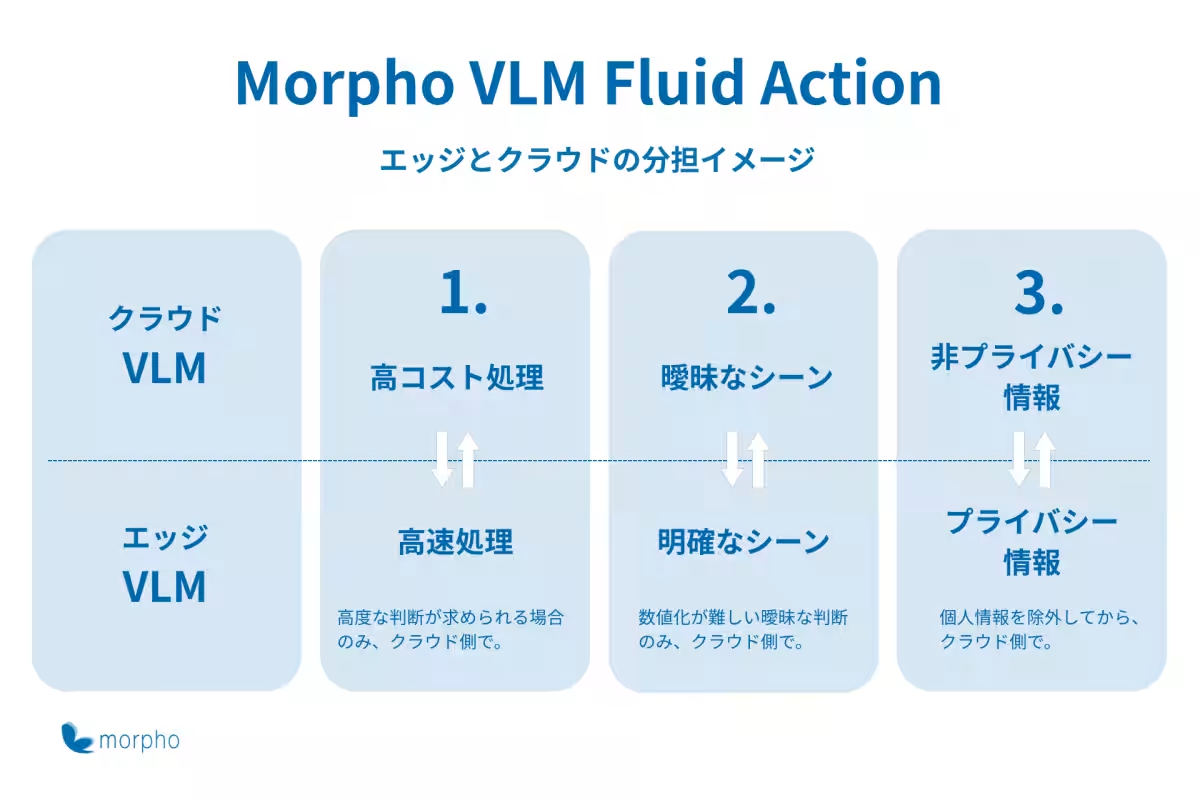
『Morpho VLM Fluid Action』の特長として、シンプルな設定ファイルを用意することで、「何を認識するか」と「それに応じてどのようなアクションを取るか」を規定できます。さらに、映像を解析した後、エッジ端末での一次判断が行われ、その結果に基づいて複雑な処理をクラウドに引き継ぐ仕組みも組み込まれています。
今後求められるのは、迅速な応答を実現しつつ、専門的な分析を行うための高度な判断力です。これにより、車載システムなど異なる用途に応じた柔軟な実装が可能となります。
主な活用シーン
モルフォは、この新しい技術の活用を以下のようなシーンに対して期待しています:
1. 乗員の状態検知: 運転者の注意散漫や疲労の兆候をプロアクティブに把握することが可能です。例えば、うつむき姿勢を検知した場合、クラウドにつなげて複合的なデータを総合し、さらなる判断を行うことが想定されています。
2. 車内の忘れ物検知: 同技術を利用すれば、乗客の忘れ物を認識し、適切なアクションへと結びつけることができるでしょう。
3. 車外映像の特定シーン解析: 路肩駐車、信号の変化など、車外シーンにおける事象を認識し、リスクマネジメントに寄与します。
幅広い業界への展開
この技術は、車載領域のみならず、建機やスマートシティ、物流、倉庫など多岐にわたって応用されることが期待されています。例えば、建設現場では資材の状態把握や人員管理の役目を果たすことが可能です。さらには、セキュリティ分野においても、住宅などの映像を解析し不審者や異常事態を検知することが出来るなど、様々な場面での導入が見込まれています。
今後の展開と関心
『Morpho VLM Fluid Action』は今後、各具体的なユースケースに向き合いながら、技術の開発・検証を進めてまいります。また、企業やパートナーとの連携を通じて、現場でのニーズに応じたアプローチを模索していく予定です。
結論
株式会社モルフォは、映像解析技術のさらなる進展を目指し、具体的なユースケースや現場のニーズに応じたアプローチを強化していく意向です。今後の活動に注目が集まります。公式サイトもぜひご覧ください。モルフォ公式サイト
会社情報
- 会社名
- 株式会社モルフォ
- 住所
- 東京都千代田区神田錦町 2-2-1 KANDA SQUARE11階 WeWork内
- 電話番号
トピックス(IT)
【記事の利用について】
タイトルと記事文章は、記事のあるページにリンクを張っていただければ、無料で利用できます。
※画像は、利用できませんのでご注意ください。
【リンクついて】
リンクフリーです。